

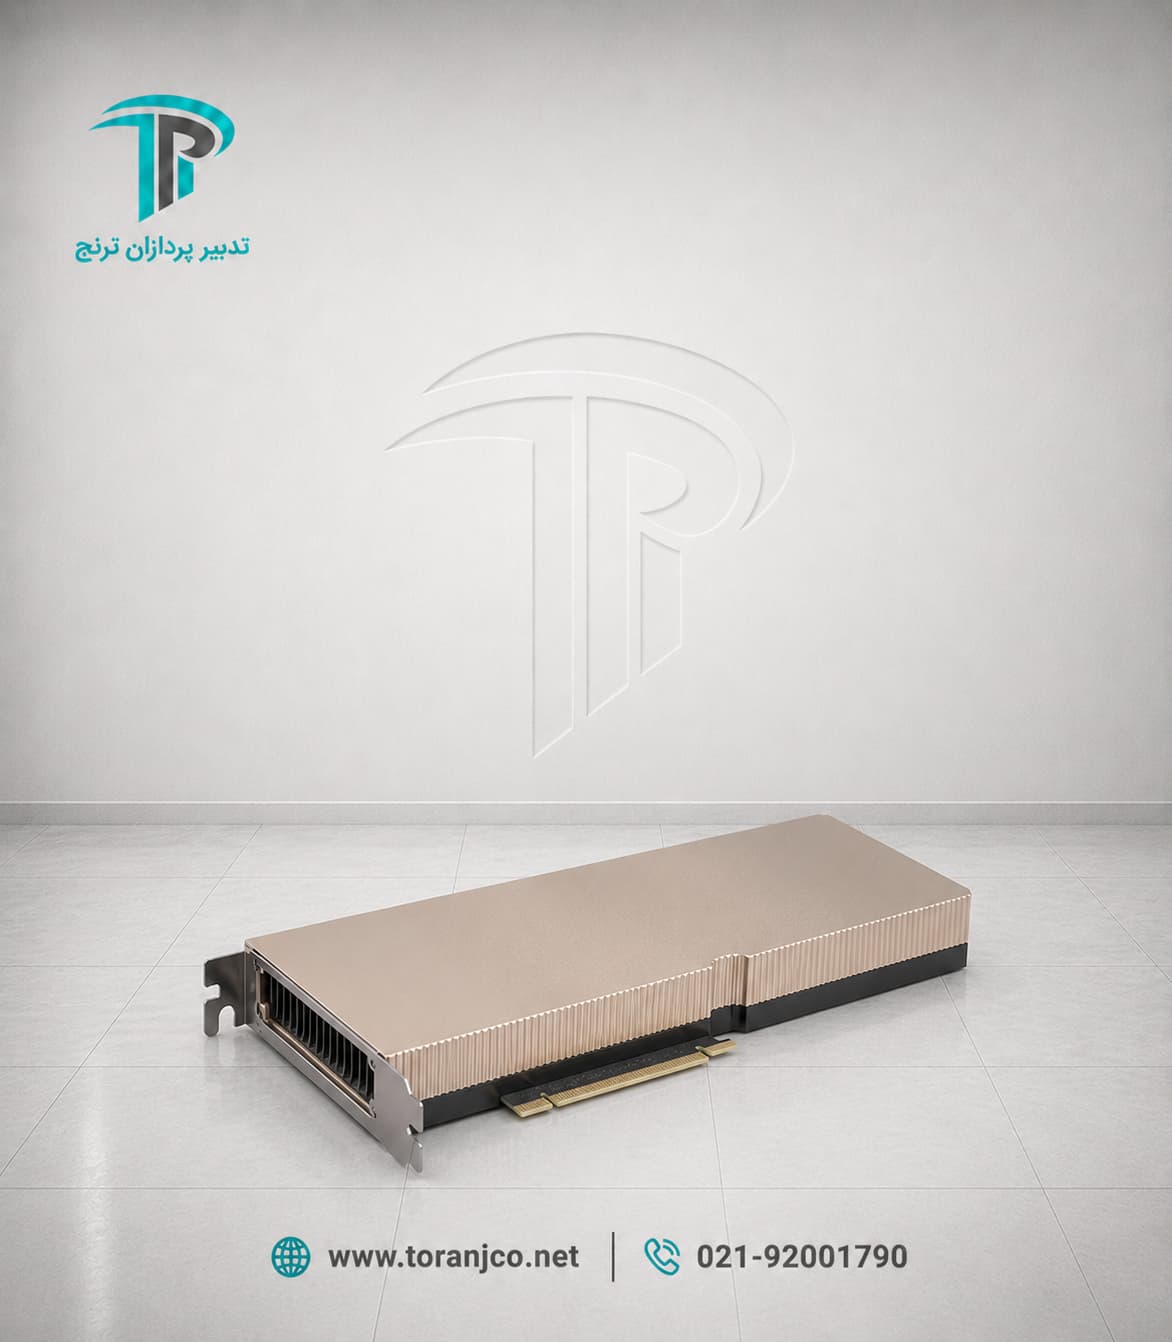
کارت گرافیک PNY NVIDIA H200 NVL 141GB
کارت PNY NVIDIA H200 NVL 141GB با پارت نامبر TCSH200NVLPCIE-PB یک شتابدهنده دیتاسنتری نسل Hopper برای پردازشهای هوش مصنوعی، مدلهای زبانی بزرگ (LLM)، استنتاج و آموزش مدلهای AI و محاسبات HPC است. این کارت به 141GB حافظه HBM3e با پهنای باند 4.8TB/s، رابط PCIe 5.0 x16 و 528 هسته Tensor مجهز شده و از NVIDIA NVLink برای اتصال چند GPU پشتیبانی میکند. طراحی Passive و توان قابل تنظیم تا 600 وات، آن را برای سرورهای دیتاسنتری مجهز به سیستم خنکسازی مناسب طراحی کرده است.
پارت نامبر:
 مشخصات محصول
| برند |
NVIDIA |
|---|---|
| حافظه گرافیکی |
141GB HBM3e |
| رابط اتصال |
PCIe 5.0 x16 |
| فرم فاکتور |
PCIe Dual Slot |
0 تومان
تکمیل اطلاعات
توضیحات
ویژگیهای کلیدی
معماری GPU: NVIDIA Hopper
حافظه: 141GB HBM3e
پهنای باند حافظه: 4.8TB/s
رابط: PCIe 5.0 x16
تعداد CUDA Core: 16,896
تعداد Tensor Core: 528
FP64: 34 TFLOPS
FP32: 67 TFLOPS
FP64 Tensor Core: 67 TFLOPS
FP8 Tensor Core: تا 3,958 TFLOPS با Sparsity
پشتیبانی از MIG تا 7 Instance
پشتیبانی از NVIDIA NVLink تا 900GB/s
پشتیبانی از Confidential Computing
حداکثر توان قابل تنظیم: 600W
خنککننده: Passive
فرم فاکتور: PCIe / Dual Slot
بدون خروجی تصویر؛ مخصوص پردازشهای دیتاسنتری
کارت گرافیک PNY NVIDIA H200 NVL 141GB
معرفی NVIDIA H200 NVL PNY
PNY NVIDIA H200 NVL 141GB یک GPU حرفهای برای دیتاسنتر است که بر پایه معماری NVIDIA Hopper ساخته شده و برای بارهای کاری سنگین AI و HPC توسعه یافته است. تمرکز این محصول بیشتر روی پردازش مدلهای هوش مصنوعی، LLMها، تحلیلهای علمی و محاسبات شتابیافته است و مانند کارتهای گرافیکی Workstation یا Gaming برای خروجی تصویر طراحی نشده است. PNY پارت نامبر TCSH200NVLPCIE-PB را برای نسخه PCIe این شتابدهنده ثبت کرده است.
یکی از ویژگیهای مهم H200 NVL، ترکیب ظرفیت بسیار بالای حافظه با پهنای باند بالا است. این ترکیب به GPU اجازه میدهد مدلها و Datasetهای بزرگتری را با وابستگی کمتر به انتقال داده میان حافظه سیستم و حافظه GPU پردازش کند.
حافظه 141GB HBM3e با پهنای باند 4.8TB/s
H200 NVL به 141GB حافظه HBM3e مجهز است. حافظه HBM3e برای پردازشهای سنگین و Data-Intensive طراحی شده و در این GPU پهنای باند حافظه به 4.8TB/s میرسد.
ظرفیت 141GB برای بارهایی مانند مدلهای زبانی بزرگ، Generative AI، پردازش Datasetهای حجیم و شبیهسازیهای علمی اهمیت ویژهای دارد. حافظه GPU از ECC نیز پشتیبانی میکند که برای پردازشهای طولانیمدت و حساس دیتاسنتری اهمیت دارد.
معماری NVIDIA Hopper
H200 NVL بر پایه معماری NVIDIA Hopper و GPU خانواده GH100 ساخته شده است. این معماری برای پردازش موازی AI و HPC طراحی شده و در کنار CUDA Coreهای متعدد، از نسل جدید Tensor Coreها برای محاسبات ماتریسی و عملیات یادگیری ماشین استفاده میکند.
این کارت دارای 16,896 CUDA Core و 528 Tensor Core است. عملکرد اعلامشده برای FP32 برابر با 67 TFLOPS و برای FP64 برابر با 34 TFLOPS است؛ در پردازشهای Tensor نیز توان بسیار بالاتری در دقتهایی مانند FP8، FP16 و BF16 ارائه میشود.
عملکرد Tensor Core
یکی از نقاط قوت H200 NVL، عملکرد بالای Tensor Core در پردازشهای AI است. PNY برای این مدل حداکثر 3,958 TFLOPS در FP8 و INT8 Tensor Core و 1,979 TFLOPS در FP16 و BF16 Tensor Core را با استفاده از Sparsity اعلام کرده است.
این توان پردازشی برای Training و Inference مدلهای یادگیری عمیق، پردازش LLMها، Generative AI و سرویسهای AI با تعداد درخواست بالا کاربرد دارد.
رابط PCIe 5.0 x16
PNY H200 NVL از رابط PCI Express 5.0 x16 استفاده میکند. پهنای باند رابط PCIe Gen5 در مشخصات H200 NVL تا 128GB/s اعلام شده است.
استفاده از PCIe 5.0 باعث میشود ارتباط GPU با CPU و سایر اجزای سرور پهنای باند مناسبی برای Workloadهای سنگین فراهم کند. با این حال، استفاده صحیح از کارت نیازمند سروری است که PCIe Gen5، توان مورد نیاز و سیستم خنکسازی مناسب برای یک GPU دیتاسنتری 600 واتی را پشتیبانی کند.
پشتیبانی از NVIDIA NVLink
H200 NVL علاوه بر PCIe، از NVIDIA NVLink نیز پشتیبانی میکند. در پیکربندیهای سازگار، دو یا چهار GPU میتوانند از طریق NVLink Bridge به یکدیگر متصل شوند و پهنای باند ارتباط GPU-to-GPU تا 900GB/s ارائه شود.
این قابلیت برای Workloadهایی اهمیت دارد که پردازش میان چند GPU تقسیم میشود و ارتباط سریع میان حافظه و منابع پردازشی GPUها نقش مهمی در عملکرد نهایی دارد؛ برای مثال Training مدلهای بزرگ و برخی پروژههای HPC.
پشتیبانی از Multi-Instance GPU یا MIG
H200 NVL از فناوری Multi-Instance GPU یا MIG پشتیبانی میکند. بر اساس مشخصات PNY، امکان ایجاد تا 7 MIG با Profileهای 18GB وجود دارد.
MIG به مدیر زیرساخت اجازه میدهد منابع GPU را به چند Instance مستقل تقسیم کند تا چند سرویس یا Workload بتوانند از یک GPU فیزیکی استفاده کنند. این ویژگی در محیطهای Cloud، سرویسهای AI اشتراکی و دیتاسنترهایی که چند Workload همزمان دارند کاربرد زیادی دارد.
پشتیبانی از Confidential Computing
یکی دیگر از قابلیتهای H200 NVL پشتیبانی از Confidential Computing است. این قابلیت برای سناریوهایی اهمیت دارد که پردازش دادههای حساس در محیطهای اشتراکی یا Cloud باید با سطح بالاتری از حفاظت انجام شود. PNY این قابلیت را در مشخصات رسمی H200 NVL تأیید کرده است.
طراحی Passive و مناسب دیتاسنتر
H200 NVL از سیستم خنککننده Passive استفاده میکند؛ یعنی کارت فن مستقل ندارد و برای دفع حرارت به جریان هوای کنترلشده داخل سرور وابسته است. این نوع طراحی در GPUهای دیتاسنتری رایج است، زیرا سیستم خنکسازی سرور میتواند جریان هوای مورد نیاز چند Accelerator را مدیریت کند.
به همین دلیل، نصب TCSH200NVLPCIE-PB در یک سیستم معمولی Desktop توصیه نمیشود. سرور باید از نظر Airflow، فضای فیزیکی، توان و Riser بهطور مشخص برای چنین GPU قدرتمندی مناسب باشد.
توان مصرفی تا 600 وات
حداکثر TDP قابل تنظیم H200 NVL برابر با 600 وات است. این میزان توان، H200 NVL را در گروه GPUهای پرمصرف دیتاسنتری قرار میدهد و هنگام طراحی سرور باید ظرفیت Power Supply، کابل GPU و محدودیتهای توان شاسی در نظر گرفته شود.
در نتیجه، سازگاری این کارت فقط به وجود یک Slot PCIe محدود نمیشود و مدل دقیق سرور و Configuration آن باید برای استفاده از H200 NVL بررسی شود.
پردازش ویدئو و کاربردهای AI
H200 NVL دارای 7 واحد NVDEC و 7 واحد JPEG Decoder است. این واحدهای اختصاصی برای پردازش Decode و دادههای تصویری در Workloadهای پشتیبانیشده مورد استفاده قرار میگیرند.
با این حال، کاربرد اصلی کارت همچنان پردازشهای AI و HPC است و مهمترین ارزش آن در ظرفیت حافظه HBM3e، پهنای باند بالا، Tensor Coreها و قابلیت اتصال چند GPU قرار دارد.
مناسب برای مدلهای زبانی بزرگ و Generative AI
یکی از مهمترین سناریوهای استفاده از H200 NVL، اجرای LLM و Generative AI است. حافظه 141GB و پهنای باند 4.8TB/s برای مدلهایی که به ظرفیت حافظه و جابهجایی سریع داده نیاز دارند، مزیت قابلتوجهی ایجاد میکند. PNY نیز H200 NVL را مشخصاً برای Generative AI، مدلهای زبانی بزرگ و HPC معرفی میکند.
در محیطهایی که اندازه مدل از ظرفیت GPUهای معمولی فراتر میرود، ظرفیت بالای HBM3e میتواند تعداد انتقالهای داده و تقسیمبندی مدل میان منابع مختلف را کاهش دهد.
NVIDIA AI Enterprise
PNY در مشخصات H200 NVL اعلام کرده است که NVIDIA AI Enterprise برای این پلتفرم در نظر گرفته شده است. این مجموعه نرمافزاری برای استقرار و مدیریت Workloadهای AI سازمانی مورد استفاده قرار میگیرد و در کنار اکوسیستم CUDA و ابزارهای NVIDIA، امکان ساخت زیرساختهای AI در مقیاس دیتاسنتر را فراهم میکند.
کاربرد GPU PNY H200 NVL
این شتابدهنده برای طیف گستردهای از Workloadهای محاسباتی سنگین کاربرد دارد، از جمله:
آموزش و استنتاج مدلهای هوش مصنوعی
Generative AI
اجرای LLM و مدلهای زبانی بزرگ
Deep Learning و Machine Learning
تحلیل دادههای حجیم
محاسبات علمی
High Performance Computing یا HPC
زیرساختهای چند-GPU
سرویسهای AI در محیطهای Cloud و Enterprise
پشتیبانی همزمان از MIG و NVLink باعث میشود H200 NVL هم برای تقسیم منابع میان چند Workload و هم برای اجرای پردازشهای چند-GPU قابل استفاده باشد.
مزایای PNY NVIDIA H200 NVL
مهمترین ویژگی H200 NVL، ترکیب 141GB حافظه HBM3e با پهنای باند 4.8TB/s و معماری Hopper است. در کنار آن، 528 Tensor Core، رابط PCIe 5.0 x16 و پشتیبانی از NVLink، این کارت را برای پردازشهای AI در مقیاس بالا مناسب میکنند.
قابلیت MIG، Confidential Computing، طراحی Passive و امکان استفاده از NVIDIA AI Enterprise نیز باعث میشوند این GPU برای زیرساختهای سازمانی و دیتاسنتری انعطاف مناسبی داشته باشد.
جمعبندی
PNY NVIDIA H200 NVL 141GB با پارت نامبر TCSH200NVLPCIE-PB یک شتابدهنده حرفهای مبتنی بر معماری NVIDIA Hopper است که برای AI، LLM، Generative AI و HPC طراحی شده است. این مدل 141GB حافظه HBM3e با پهنای باند 4.8TB/s، رابط PCIe 5.0 x16 و 528 Tensor Core در اختیار پردازشهای دیتاسنتری قرار میدهد.
پشتیبانی از NVLink تا 900GB/s، MIG تا 7 Instance، Confidential Computing و توان قابل تنظیم تا 600 وات، H200 NVL را به یک Accelerator تخصصی برای سرورهای مجهز به زیرساخت مناسب تبدیل کرده است.

نقد و بررسیها
پاکسازی فیلترهنوز بررسیای ثبت نشده است.